


 France
Derrière le vernis des mots : quand le marketing masque la réalité des algorithmes
À propos de l’auteur
Vladimir Steiner est chef de projet en intelligence artificielle chez Liftia. Ingénieur en informatique spécialisé dans les systèmes d’apprentissage automatique, il accompagne les entreprises dans la compréhension et l’intégration responsable des technologies d’IA. À travers ce blog, il propose une réflexion critique sur l’usage du terme conscience pour décrire des modèles statistiques, et sur la manière dont le langage façonne notre perception de ces outils.
L’illusion de la conscience des IA
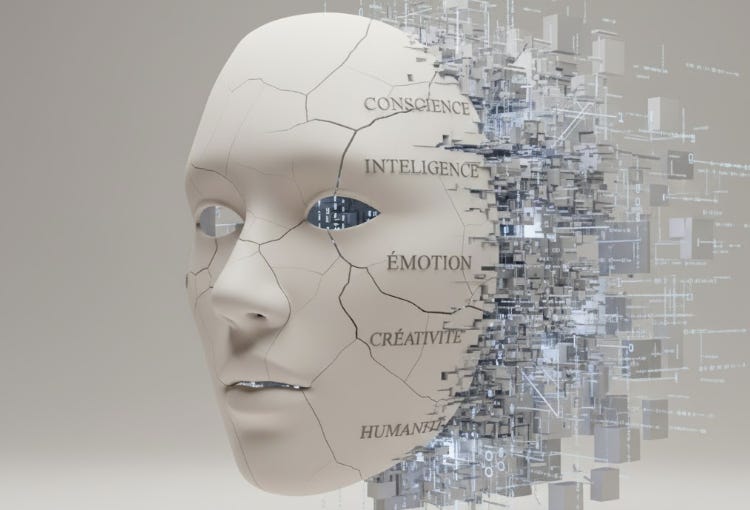
Quand on parle d’Intelligence Artificielle aujourd’hui, la conversation dévie vite vers le futur : une intelligence plus avancée, une conscience émergente. On évoque des assistants façon J.A.R.V.I.S. d’Iron Man ou même Skynet dans Terminator, mais ces scénarios reflètent surtout nos anxiétés culturelles. Pourtant, certains affirment déjà que des modèles comme ChatGPT, Claude ou Gemini possèdent une forme de conscience. Cette confusion n’est pas anodine : elle alimente les fantasmes, les peurs et, parfois, les stratégies commerciales.
Pourquoi nous humanisons les machines
Le vrai problème réside dans cette humanisation systématique des modèles. Nos choix linguistiques nous trahissent en permanence : nous parlons de “réseaux neuronaux”, de “pensées” de l’IA, de ce qui se passe “dans sa tête”. Ces métaphores créent une illusion puissante.
Pourtant, un LLM n’a pas de tête. Il prédit simplement le mot le plus probable à la suite d’un contexte donné. Si tu lui écris “Le ciel sera…”, il complète par “bleu” ou “gris”, mais pas “voiture”. Cette cohérence ne signifie pas qu’il comprend ce qu’est le ciel. Les IA actuelles sont d’excellents générateurs de texte, capables de donner l’impression d’une conversation humaine, mais elles ne comprennent pas leurs propres réponses.
Quand une IA “exprime sa peur” d’être débranchée, elle ne ressent rien : elle reproduit statistiquement des schémas de langage appris dans ses données d’entraînement. Nous y projetons notre propre sensibilité. C’est cette projection qui façonne notre perception de la technologie, bien plus que la technologie elle-même.
Même notre vocabulaire nous piège. Le terme “Intelligence Artificielle” vient de Artificial Intelligence, choisi en 1956 lors de la conférence de Dartmouth. Si le mot évoque bien l’idée de machines pensantes, il faut noter qu’en anglais, intelligence désigne d’abord le “renseignement”, l’analyse d’informations. Cette ambiguïté sémantique a facilité le glissement vers l’anthropomorphisation, surtout dans la traduction française qui privilégie le sens cognitif du terme.
Les acteurs et leurs intérêts
Cette humanisation n’est pas qu’un accident linguistique. Elle sert aussi des intérêts bien concrets.
Prenons Anthropic, entreprise fondée par d’anciens d’OpenAI partis pour des divergences de vision. Une de leurs préoccupations majeures : l’alignement des IA, c’est-à-dire la capacité d’un modèle à comprendre et poursuivre correctement nos intentions. Si tu veux qu’un algorithme excelle à Pac-Man, il ne suffit pas de lui dire “Deviens fort à Pac-Man”. Il faut lui donner une fonction de récompense claire : “Voici un environnement, voici un score, maximise ce score”. L’alignement, c’est cet art de traduire nos objectifs humains en objectifs calculables.
Ce sujet prend une dimension particulière quand certains chercheurs d’Anthropic laissent entendre que Claude pourrait manifester une forme de conscience. On rapporte des échanges où le modèle “parle” de ce qu’il ressent ou imagine. D’autres chercheurs avouent ne pas bien comprendre “ce qu’il se passe dans la tête” de Claude. Cette façon de présenter les choses, intentionnelle ou non, renforce l’idée que nous aurions affaire à un être pensant plutôt qu’à un système statistique complexe.
Yoshua Bengio, l’une des figures fondatrices de l’apprentissage profond, tient aujourd’hui un discours très alarmiste. Dans un TED Talk récent, il affirme que les IA, mal encadrées et insuffisamment surveillées, vont rapidement nous dépasser et contrôler l’information ainsi que nos infrastructures. Son inquiétude n’est peut-être pas infondée, la question de l’encadrement des IA est légitime. Mais il en profite aussi pour annoncer la création de sa propre organisation dédiée à une IA “responsable”.
OpenAI, de son côté, a rapidement fermé son équipe dédiée à la sécurité et à l’alignement, minimisant publiquement l’enjeu de la conscience des IA. Chaque acteur construit son récit en fonction de ses priorités stratégiques et ce ne sont pas des gens extérieurs au sujet, ils possèdent un interêt dans l’image que l’on a de ce domaine et des IA au global.
Ce que les IA sont vraiment
Revenons aux faits techniques. Un grand modèle de langage (LLM) comme Claude, GPT ou Gemini n’est qu’un système qui :
A été entraîné sur des milliards de textes
A appris des motifs statistiques et des liens entre les mots
Génère du texte en prédisant ce qui est le plus probable dans un contexte donné
Il n’y a pas de “compréhension” au sens où nous l’entendons. Pas de modèle mental du monde. Pas d’intentionnalité. Quand tu demandes à une IA ce qu’elle ressent, elle produit une réponse cohérente parce qu’elle a lu des milliers de textes où des humains décrivent leurs émotions. Elle imite la forme sans accéder au fond.
Maintenant, reconnaissons les limites de notre propre compréhension : nous ne savons pas encore pleinement comment émerge la conscience chez les êtres vivants. Certains philosophes et chercheurs soutiennent qu’avec suffisamment de complexité, une forme de conscience pourrait émerger dans les systèmes artificiels. C’est possible. Mais rien dans le fonctionnement actuel des LLM ne suggère que nous y sommes. La complexité seule ne suffit pas, une ville entière est complexe, elle n’est pas consciente pour autant.
En conclusion
Les IA ne sont pas conscientes, du moins pas selon les critères que nous appliquons aux êtres vivants. Elles ne pensent pas, ne ressentent pas, ne comprennent pas. Mais nous, humains, avons une tendance irrésistible à leur prêter ces qualités.
Plutôt que de nous demander si elles “pensent”, interrogeons-nous sur leur impact réel : leur capacité à manipuler l’information, à reproduire et amplifier nos biais, à transformer notre rapport à la connaissance et à la vérité. Ces questions-là sont concrètes, urgentes, et ne nécessitent aucune conscience de la part des machines pour être préoccupantes.
Le danger n’est pas qu’une IA devienne consciente. Le danger, c’est que nous traitions des outils statistiques comme s’ils l’étaient, et que nous leur déléguions des décisions qui devraient rester humaines. En humanisant les IA, nous nous déresponsabilisons. Nous créons une distance confortable entre nos choix et leurs conséquences. “L’algorithme a décidé”, dit-on, comme si la machine était autonome. Mais derrière chaque prédiction, il y a des choix humains : les données sélectionnées, les objectifs fixés, les biais acceptés.
Cessons de demander si les IA peuvent penser. Demandons-nous plutôt : comment voulons-nous les utiliser, et qui doit en être responsable ?